| 前口上 | 目次 | 第1章 | 第2章 | 第3章 | 第4章 | 第5章 | 第6章 | 第7章 | 第8章 | 第9章 | 第10章 |
| 第11章 | 第12章 | 第13章 | 第14章 | 第15章 | 第16章 | 第17章 | 第18章 | 第19章 | 第20章 | 付録 |
| 1 | 2 | 3 | 4 | 5 | 6 | 7 |
パラメトリックモデルは次のような仮定を置いています。
一般には、1番目の仮定を比例ハザード性の仮定といいます。 しかしこの仮定が成り立っても、2番目の仮定が成り立たなければパラメトリックモデルを用いた生命表解析の結果は精度が悪くなります。 そのためこれら2つの仮定をひっくるめて比例ハザード性の仮定と考えた方が実際的です。
現実にはこれらの仮定はほとんど成り立ちません。 しかしこの仮定を置かないと生命表解析の解を求められないので、普通は近似的に成り立っていると仮定して解を求めます。 ただしそれについて知らんぷりをしているのはさすがに後ろめたいので、比例ハザード性が近似的に成り立っているかどうかを検討する方法が色々と提案されています。
例えば表11.1.1のデータと、この表のB群のデータを変更してC群のデータにした表11.7.1のようなデータがあったとします。
| 症例番号 | 手術法 | 観察期間(月) | 転帰 |
|---|---|---|---|
| 1 | A | 4 | 脱落 |
| 2 | A | 5 | 死亡 |
| 3 | A | 8 | 死亡 |
| 4 | A | 13 | 死亡 |
| 5 | A | 16 | 打ち切り |
| 6 | A | 27 | 死亡 |
| 7 | A | 28 | 死亡 |
| 8 | A | 32 | 打ち切り |
| 9 | A | 35 | 打ち切り |
| 10 | A | 36 | 死亡 |
| 11 | A | 50 | 打ち切り |
| 12 | A | 56 | 打ち切り |
| 13 | C | 11 | 死亡 |
| 14 | C | 16 | 死亡 |
| 15 | C | 20 | 死亡 |
| 16 | C | 24 | 死亡 |
| 17 | C | 28 | 死亡 |
| 18 | C | 32 | 死亡 |
| 19 | C | 36 | 死亡 |
| 20 | C | 42 | 死亡 |
| 21 | C | 50 | 死亡 |
| 22 | C | 56 | 死亡 |
これらのデータに指数分布モデルによるパラメトリック多変量生命表解析を適用すると、次のような結果になります。
この結果に基いて、A群の理論的生存関数S(t|x=0)とB群またはC群の理論的生存関数S(t|x=1)、そして2群の累積生存率曲線を描いたものが図11.6.1と図11.7.1です。
図11.6.1では累積生存率曲線と理論的生存関数がうまく適合していて、しかも2本の累積生存率曲線がほぼ平行なので、比例ハザード性が近似的に成り立っていると考えられます。 それに対して図11.7.1ではC群の累積生存率曲線と理論的生存関数がうまく適合しておらず、しかも2本の累積生存率曲線が途中で交わっているので、比例ハザード性が成り立っていないと考えられます。
そこで生存時間解析で最も重要な指標である生存時間を用いて、モデルの適合度と比例ハザード性を検討してみましょう。 理論的生存関数S(t)を利用すると、共変数が特定の値の患者の時点tにおける予測生存率を求めることができます。 そしてその逆に共変数が特定の値の患者の予測生存率から、その患者の生存時間を逆算することも可能です。 そこで上記のパラメトリック多変量生命表解析の結果に基いて、A群(x = 0)とB群またはC群(x = 1)の患者が予測生存率50%になる時点t、つまり50%生存時間を逆算すると次のようになります。
図11.6.1と図11.7.1を見ると、これらの50%生存時間の値が納得できると思います。 各群の死亡例は、理論的には50%生存時間よりも前に死亡した例数と後に死亡した例数が半々になるはずです。 そして50%生存時間と実際の死亡例の生存時間の一致度を調べれば、モデルの適合度の目安になります。 さらに50%生存時間と実際の死亡例の生存時間の差つまり残差が共変数の値とも時間とも無関係に無作為にバラついていれば、比例ハザード性が近似的に成り立っていると考えられます。
そこで上記の50%生存時間と実際の死亡例の生存時間を対数変換して級内相関係数ICC(3,1)を求め、残差分析を行うと次のようになります。 生存時間を対数変換するのは、ハザード関数λ(t)では生存時間tと共変数xを指数変換したexp(x)の間に比例関係があるので、両者を対数変換してln(t)とxの関係を直線的にするためです。 (→5.4 級内相関係数と一致係数)
表11.1.1の生存時間の一致係数つまり対数生存時間の級内相関係数C(3,1)は0.212です。 ICC(3,1)は完全一致の時は 1 になり、正反対なら-1になり、偶然の一程度の一致の時は 0 になります。 そのため0.212という値は低い一致度と解釈できます。 ただし変数が1つだけで、しかもそれは「0/1」のダミー変数であることを考慮すると、この一致係数をある程度は評価して良いと思います。
参考までに、比例ハザードモデルで用いられるC統計量を計算すると0.638になります。 C統計量は死亡順序の一致度を表す順位一致係数であり、完全一致の時は 1 になり、正反対の時は 0 になり、偶然の一程度の一致の時は0.5になります。 そのため0.638という値はやはり低い一致度と解釈できます。 ちなみにC統計量の値は、これらのデータに比例ハザードモデルを当てはめた時も同じ値になります。 (→11.4 比例ハザードモデル (注3))
また図11.7.2からわかるように、A群では50%生存時間35.8ヶ月以前に死亡した患者が5例で、35.8ヶ月以後に死亡した患者が1例です。 それに対してB群では50%生存時間である13ヶ月以前に死亡した患者が4例で、13ヶ月以後に死亡した患者も4例です。 そのため残差は生存時間が長いほど負の方向に少し偏る、つまり実際の生存時間が50%対数生存時間よりも少し短くなる傾向があります。
しかしA群とB群の50%生存時間の差は22.8ヶ月であり、対数生存時間の差にすると約1です。 そして残差の回帰係数が-0.585ですから、2群の残差の差は2群の50%対数生存時間の差の半分程度です。 これは小さな差なので、このデータでは比例ハザード性が近似的に成り立っていると考えて良いと思います。
一方、表11.7.1の生存時間の一致係数は-0.285です。 これは生存時間が一致しておらず、むしろ逆の傾向――モデルから予想される50%生存時間が長いと実際の死亡例の生存時間は短い――があることを表しています。 そしてC統計量は0.514ですから、モデルから予想される死亡順序と実際の死亡順序の一致度は偶然の一致程度ということになります。
また図11.7.3からわかるように、A群の50%生存時間と、50%生存時間以前と以後に死亡した例数は表11.1.1と同じです。 それに対してC群では50%生存時間である21.8ヶ月以前に死亡した患者が3例で、13ヶ月以後に死亡した患者は7例です。 そのため残差は生存時間が長いほど負の方向にかなり偏る、つまり実際の生存時間が50%対数生存時間よりもかなり短くなります。 そして残差の回帰係数が-2.204ですから、対数生存時間が 1 長くなると、実際の対数生存時間が50%対数生存時間よりも約2.2ほど短くなります。 これは大きな差なので、このデータでは比例ハザード性が成り立っていないと考えられます。
比例ハザード性が成り立っていない主な原因は、2群の累積生存率曲線が途中で交差していることです。 そしてそのせいで、C群の累積生存率曲線と理論的生存関数がうまく適合していません。 そこでC群のデータにワイブル分布モデルを適用すると、次のように累積生存率曲線と理論的生存関数がうまく適合します。
上記のようにこの場合のハザード比は1.448であり、2群とも指数分布を適用した時のハザード比1.640よりも少し小さくなります。 ただしこのハザード比は全観察期間の平均的な値です。 図11.7.4を見ると、2本の理論的生存率曲線は30ヶ月後あたりで交わっています。 この交点は指数分布モデルの生存関数とワイブル分布モデルの生存関数から理論的に求めることができて、約27.6ヶ月後になります。 (注1)
このことからA群は指数分布モデルが当てはまり、指数関数的に生存率が低下していくのに対して、C群はワイブル分布モデルが当てはまり、最初のうちは生存率があまり低下しないものの、20ヶ月後くらいから急激に低下し、28ヶ月以後はA群よりも生存率が低くなることがわかります。 そしてA群とC群はそれぞれ手術法Aと手術法Cを施したのですから、28ヶ月までの短期間なら手術法Cの方が成績が良く、28ヶ月以上の長期間なら手術法Aの方が成績が良いと考えられます。
このように比例ハザード性が成り立たない時や、累積生存率曲線と理論的生存関数がうまく適合しない時は、累積生存率曲線とうまく適合するパラメトリックモデルを検討することが大切です。 それによって平均的なハザードを単純に比較するよりも有用な情報が得られる可能性があります。
比例ハザードモデルは次のような仮定を置いています。
パラメトリックモデルと同様に、一般には1番目の仮定を比例ハザード性の仮定と呼んでいます。 そして2つの仮定をひっくるめて比例ハザード性の仮定と考えた方が実際的なこともパラメトリックモデルと同様です。 ただし2番目の仮定はパラメトリックモデルの2番目の仮定よりもさらに非現実的な仮定であり、現実にはほとんど有り得ません。 しかしハザード関数をブラックボックスにしたまま近似解を求めるために、苦肉の策としてこの非現実的な仮定を置いているのです。
表11.1.1のデータと表11.7.1のデータに比例ハザードモデルによる多変量生命表解析を適用すると、次のような結果になります。
これらの結果はパラメトリック多変量生命表解析の結果と似ています。 ただし比例ハザードモデルによる生命表解析は、死亡例の生存時間の情報は用いず、死亡の順序の情報だけを用いて精度の悪い近似解を求めるノンパラメトリックな手法です。 そのためパラメトリック多変量生命表解析と違って理論的生存関数S(t|x)を求められません。
理論的生存関数を求められないということは、共変数が特定の値の患者の時点tにおける予測生存率を求めることはできませんし、予測生存率から患者の生存時間を逆算することもできません。 そのため50%生存時間と実際の死亡例の生存時間の一致度を利用してモデルの適合度を検討することはできませんし、50%生存時間と実際の死亡例の残差を利用して比例ハザード性が近似的に成り立っているかどうかを検討することもできません。
そもそも比例ハザードモデルの2番目の仮定「ハザード関数は結果に影響を与えない」から考えて、ハザード関数に関して比例ハザード性が成り立っているかどうかを検討することは原理的に不可能です。 そのため対数ハザード比と共変数の線形関係に関してだけ、比例ハザード性が成り立っているかどうかを検討する方法が色々と提案されています。 そのひとつであるシェーンフェルド(Schoenfeld)残差を利用する方法を紹介しましょう。
第4節で説明したように、比例ハザードモデルは次のような式で表されます。

この式の回帰誤差εについて残差分析を行い、εが共変数の値にも時間にも無関係にバラついていれば、対数ハザード比と共変数の線形関係に関して比例ハザード性が成り立っていると考えられます。 しかしこのモデルは部分尤度法を用いて近似解を求めるのでεの残差分析ができません。
そこで苦肉の策として、偏回帰係数の近似解を求める時の計算誤差を回帰誤差のように扱って残差分析を行うことをシェーンフェルド(David Schoenfeld)が提案しました。 最尤法と同様に、部分尤度法でも通常はニュートン・ラプソン(Newton-Raphson)法を利用して偏回帰係数近似解を求めます。 その際、死亡例ごとの共変数の値と、その死亡例が発生した時点における共変数の期待値(ハザード比で重み付けした重み付け平均値)の差を用いて偏回帰係数の近似解を求めます。 その差のことをシェーンフェルド残差(Schoenfeld residuals)と呼び、これを利用して仮想的に残差分析を行うのです。(David Schoenfeld、1982年)
その仮想的な残差分析の結果、残差が共変数の値にも時間にも無関係にバラついていれば、「ニュートン・ラプソン法による偏回帰係数の近似解は共変数にも時間にも無関係にほぼ一定である」≒「対数ハザード比と共変数の線形関係に関して比例ハザード性が成り立っている」と強引に結論します。 これは部分尤度法と同様に苦し紛れのトリックですが、他に良い方法がないのでけっこう利用されているようです。 (注2)
表11.1.1のデータと表11.7.1のデータについて、死亡例ごとの生存時間の順位を横軸にし、シェーンフェルド残差を縦軸にしてプロットすると図11.7.5と図11.7.6のようになります。 比例ハザードモデルは死亡例の生存時間の情報は用いず、生存時間の順番だけを用いて近似解を求め、それによって死亡例の死亡順序だけを予測するノンパラメトリック手法です。 そのため生存時間そのものではなく、生存時間の順番についてシェーンフェルド残差がどのような変動をしているかを検討するのです。
シェーンフェルド残差を共変数の分散で割って規格化し、偏回帰係数の近似解から引くことによって死亡例ごとの偏回帰係数推測値を求めることができます。 この規格化したシェーンフェルド残差のことを規格化シェーンフェルド残差(Scaled Schoenfeld residuals)と呼び、これも比例ハザード性の検討によく用いられます。
しかしシェーンフェルド残差も規格化シェーンフェルド残差も、ハザード比を直接的に反映する値ではありません。 そして上記の回帰係数0.011と0.041は「生存時間順位が1つ大きくなるとシェーンフェルト残差が0.011または0.041だけ大きくなる」ということを表しています。 これを医学的に解釈するのは非常に難しいので、回帰係数が医学的に意義があるほど大きいのか、それとも無視できるほど小さいのか判断しにくいと思います。
そこで規格化シェーンフェルド残差を利用して、死亡例ごとに偏回帰係数推測値を求めます。 それを共変数の平均値に掛けると、基準ハザードλ0つまり共変数が0の時の仮想的な被験者のハザードに対する、死亡例ごとの偏回帰係数推測値を用いて求めた平均的なハザードの比を対数変換した値になります。 この対数ハザード比を用いて仮想的に残差分析を行う方が結果の解釈が容易になります。
共変数が複数の時は、複数の偏回帰係数推測値と複数の共変数の平均値を掛けて合計すると死亡例ごとの対数ハザード比になります。 そしてその対数ハザード比を用いて、モデル全体の仮想的な残差分析を行うことができます。 また偏回帰係数推測値ごとに対数ハザード比を求めて、偏回帰係数ごとに仮想的な残差分析を行うことも可能です。 そのような残差分析はモデル全体の比例ハザード性が成り立っていない時に、その主な原因を検討するのに役立ちます。
表11.1.1のデータと表11.7.1のデータについて、死亡例ごとの累積生存率を対数変換して符号を反転した値を横軸にし、対数ハザード比を縦軸にしてプロットすると図11.7.7と図11.7.8のようになります。 累積生存率を対数変換するのは、累積生存率曲線が指数関数的に変化するので、それを直線的にするためです。 そして対数累積生存率の符号を反転するのは、累積生存率は時間の経過とともに低下するので、それを反対にするためです。 図11.7.5や図11.7.6と同様に、時間の経過とともに横軸の値が大きくなる方が残差の変動が解釈しやすいのです。
以上の結果からに、対数ハザード比の回帰係数を指数変換してハザード比にすると exp(0.020) ≒ 1.02 と exp(0.039) ≒ 1.04 になります。 つまり−(対数累積生存率)が1増加すると、ハザードがそれぞれ1.02倍と1.04倍になるのです。
−(対数累積生存率)が0の時は累積生存率が1(100%)であり、−(対数累積生存率)が1の時は累積生存率が0.37(37%)です。 そのため−(対数累積生存率)が0〜1の範囲は、図11.6.1と図11.7.1の累積生存率曲線のグラフでは0ヶ月(開始時)の部分から48〜60ヶ月までの範囲になるわけです。 その範囲で図11.7.7ではハザードが1.02倍になり、図11.7.8ではハザードが1.04倍になります。 これらはどちらも小さな変化なので、どちらのデータでも比例ハザード性が近似的に成り立っていると解釈できます。
このことから、図11.7.4のように明らかに比例ハザード性が成り立っていない時でも、シェーンフェルド残差を利用した方法ではそれを検出できないことがわかると思います。 このことは、パラメトリックモデルで比例ハザード性を検討するための図11.7.2および図11.7.3と、図11.7.7および図11.7.8を比べるとはっきりわかると思います。
表11.7.1のデータで比例ハザード性が成り立っていない原因は、共変数の値によって(つまり群によって)ハザード関数の内容が変わることです。 比例ハザードモデルはハザード関数をブラックボックスにし、「ハザード関数は結果に影響を与えない」という非現実的な仮定を置いて近似解を求めます。 そのためこのデータのように、ハザード関数の変化が原因で比例ハザード性が成り立っていない時は、シェーンフェルド残差を利用した方法に限らず、どんな方法を用いてもそれを検出できないのです。
そもそも比例ハザードモデルはノンパラメトリック手法ですから、比例ハザード性のようなパラメトリックな性質を検討すること自体に無理があります。 そして比例ハザード性が成り立たない時は、「このデータには比例ハザードモデルを適用できない」という結論で終わってしまいます。
それに対してパラメトリックモデルでは、比例ハザード性が成り立っていない時とかモデルの適合度が悪い時は、モデルを色々と変えて検討し、それによって重要な情報が得られる可能性があります。 このことからも、比例ハザードモデルよりもパラメトリックモデルを用いる方が合理的であることがよくわかると思います。
比例ハザードモデルで比例ハザード性が成り立っていない時は、ハザード比の代わりに境界内平均生存時間(RMST:Restricted Mean Survival Time)を代替え指標として用いる時があります。 この指標には大きな欠点があるのであまりお勧めしませんが、一応、紹介しておきます。
生存関数S(t)は生存時間tの発生確率を表す関数なので、tについて積分すると平均生存時間になります。 例えば指数分布モデルの生存関数を t = 0〜∞ について積分すると、次のように平均生存時間になります。 (注3)
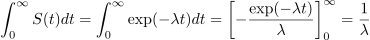
ところが実際のデータは全例が死亡するまで観察せず、たいていは全例が死亡する前に観察を打ち切ることが多いと思います。 そのため生存関数を t = ∞ まで外挿して求めた平均生存時間は、どうしても信頼性が低くなってしまいます。 そこで生存関数を実際のデータが存在する時間 t = τ まで積分し、その時間までの平均生存時間を求めれば信頼性が低くならないと考えられます。 これが境界内平均生存時間であり、指数分布モデルでは次のようになります。
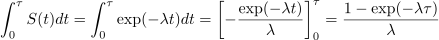
境界内平均生存時間は生存関数を積分した値なので、累積生存率曲線の曲線下面積AUC(Area Under the Curve)になります。 そのためカプラン・マイヤー法による累積生存率曲線の曲線下面積を計算することによって近似値を求められます。 例えば表11.1.1のデータについて、指数分布モデルを用いた時とカプラン・マイヤー法による累積生存率曲線を用いた時の境界内平均生存時間を求めると次のようになります。
上記のように、指数分布モデルによる境界内平均生存時間とカプラン・マイヤー法による境界内平均生存時間はまずまず近似しています。 指数分布モデルに限らず、各種のパラメトリックモデルの生存関数はカプラン・マイヤー法による累積生存率曲線の中央付近を通ります。 そのためカプラン・マイヤー法による境界内平均生存時間は、どんなパラメトリックモデルについてもまずまずの近似値になります。 したがって群によって分布モデルが異なる時でも、また分布モデルがわからない時でも実用的な近似値として用いることができます。
またA群では t = 0 から35ヶ月までの境界内平均生存時間と、t = 0 から56ヶ月までの境界内平均生存時間の2種類を計算しました。 これはB群のデータが35ヶ月までしかないので、それと比較するためです。 このように2群の境界内平均生存時間を比較する時は同じ時間までの値を比較する必要があります。 そのため2群の最終観察時間が異なっている時は、最終観察時間が多い群のデータを少し無駄にしてしまいます。
そのような難点はあるものの、境界内平均生存時間は群によって分布モデルが異なる時でも群の平均生存時間を比較できるという長所を持っています。 そこでこの長所に着目して、比例ハザード性が成り立たない時にハザード比の代替え指標として用いるわけです。
しかし境界内平均生存時間には大きな欠点があります。 (1)の最後で説明したように、比例ハザード性が成り立たない時や、累積生存率曲線と理論的生存関数がうまく適合しない時は、累積生存率曲線とうまく適合するパラメトリックモデルを検討することが大切です。 それによって平均的なハザードを単純に比較するよりも有用な情報が得られる可能性があります。 ところが境界内平均生存時間はその検討が難しいのです。
例えば表11.7.1のデータについて、指数分布モデルとカプラン・マイヤー法による累積生存率曲線を用いた時の境界内平均生存時間を求めると次のようになります。
境界内平均生存時間はA群の方が少し大きく、指数分布モデルによる2群の平均的なハザードと似た傾向です。 ただし指数分布モデルによって求めた2群の差よりも、カプラン・マイヤー法によって求めた2群の差の方が小さくなっています。 カプラン・マイヤー法によって求めた値は近似値なので、この程度の誤差は致し方ないでしょう。
しかし2群の平均的なハザードを比較するのと同様に、境界内平均生存時間を比較していただけでは、C群はワイブル分布モデルが当てはまり、最初のうちは生存率があまり低下しないものの、20ヶ月後くらいから急激に低下し、28ヶ月以後はA群よりも生存率が低くなることはわかりません。 そもそも境界内平均生存時間は原理的にハザードに反比例し、ハザードと同じ特徴を持っているノンパラメトリックな指標ですから、それは当然です。
したがって比例ハザード性が成り立たない時に境界内平均生存時間を代替え指標にするのはあまり合理的とは言えません。 そのような時は、やはり累積生存率曲線とうまく適合するパラメトリックモデルを色々と検討することが大切です。
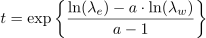
表11.7.1のデータについて求めると次のようになります。
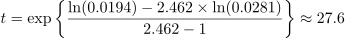


 :死亡例だけを掛け合わせる
 :リスク集合について合計する
 :dt例のxを合計したもの
この対数部分尤度関数にニュートン・ラプソン法(ニュートンの2階勾配法)を適用して偏回帰係数ベクトルβの近似解を求めます。 今、最大値(または最小値)を持つ関数をf(x)とします。 一般にf(x)は最大値の近傍では2次関数つまり放物線で近似できます。 そこでf(x)を最大値に近い値xkでテーラー展開して2次の項まで取ります。 その近似2次関数を利用して、f(x)の最大値を反復計算によって近似的に求めるのがニュートン・ラプソン法です。 (→10.3 ロジスティック回帰分析の計算方法 (注2))
 :f(x)の1次偏微係数ベクトル(傾斜ベクトル)
 :f(x)の2次偏微係数行列(Hessの行列、f(x)の曲率を表す計量行列)

対数部分尤度関数LBP(β)にニュートン・ラプソン法を適用すると、傾斜ベクトルgとHessの行列Hは次のようになります。


 :リスク集合R(t)に関してハザード比 wi = HRi で重み付けしたxiの重み付け平均値

 :リスク集合R(t)に関してハザード比 wi = HRi と wj = HRj で重み付けしたxjとxlの重み付け共分散
 または Ct = 1(ブレスロー・ペトの近似):有限修正
シェーンフェルドは上式の中のgjkを求めるための(ztj - dtatj)に目を付けて、これを仮想的に回帰残差扱いして比例ハザード性の検討に利用することを提案しました。 これがシェーンフェルド残差です。 そしてbを更新するための-H-1gの各要素は、(ztj - dtatj)をHの要素である共変数の重み付け分散で割って規格化した値になります。 これが規格化シェーンフェルド残差です。
シェーンフェルド残差は、時点tに死亡した死亡例の共変数の値xtjと、t時点まで生存していた死亡例と脱落例の共変数の値に指数的な重みwiをつけて平均した重み付け平均値atjの差に相当します。 そしてこの値を合計することによってgkを求めます。 さらにgkにHkの逆行列Hk-1を左から掛けてbkから引くことによってbkをbk+1に更新します。
そこで部分尤度法による最終的な近似解bを初期値にしてgを求めると、g≒0になるはずです。 そのため(xtj - atj)の合計はほぼ 0 になるはずですが、死亡例ごとの(xtj - atj)は全てが 0 になるわけではなく、個人差による多少のバラツキがあるはずです。 そのバラツキを回帰誤差扱いして、比例ハザード性の検討に利用しようというわけです。 そして規格化シェーンフェルド残差も同様にして比例ハザード性の検討に利用できます。
でもせっかく計算するならb≒b - H-1gまで計算すれば、死亡例ごとに多少のバラツキがある偏回帰係数推測値biを求められます。 そしてbiに共変数の平均値mxを掛けて合計したbi'mxは、死亡例ごとに多少のバラツキがある対数ハザード比 ηi = ln(HR)i になります。 このηiとその死亡例の−(対数累積生存率)をプロットしたグラフが図11.7.7と図11.7.8です。
また第4節の(注1)で説明したように、比例ハザードモデルの切片b0は全ての共変数に平均値を代入した時の対数ハザード比が 0 になるように調整した値です。 そのためηiの平均値は-b0になります。 例えば図11.7.7の各プロットの対数ハザード比を平均すると比例ハザードモデルの切片-0.553の符号を反対にした0.553になり、図11.7.8の各プロットの対数ハザード比を平均すると比例ハザードモデルの切片-0.202の符号を反対にした0.202になります。
実は部分尤度関数の最大値を近似的に求める手法としては、ニュートン・ラプソン法以外にも色々な方法があります。 そして例えば滑降シンプレックス法(滑降単体法、Downhill simpex method)を用いると、シェーンフェルド残差に相当するものはありません。 そのため比例ハザード性の検討は不可能です。 このことからも、シェーンフェルド残差を利用した比例ハザード性の検討は苦し紛れのトリックであることがわかると思います。 (→14.1 コンパートメントモデル (注2))
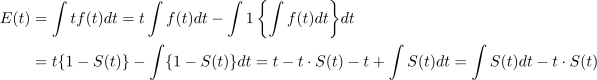
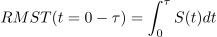
ここで t = 0〜∞ まで積分すると t・S(t) → 0 になり、期待値E(t)は生存関数S(t)を積分した値になります。 そしてS(t)を t = 0〜t まで積分した値から t・S(t) を引いた値は、tの直前の時間をτとすると、S(t)を t = 0〜τ まで積分した値になります。 tは死亡時間なのでτはtの直前までの生存時間になり、S(t)を t = 0〜τ まで積分した値は死亡時間tの直前までの平均生存時間になります。 これが境界内平均生存時間です。
指数分布モデルの場合、境界内平均生存時間とその分散は次のようになります。 この分散を用いて境界内平均生存時間の信頼区間を求めることができます。
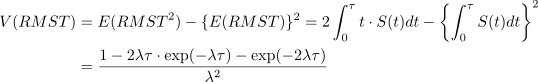
また生存関数S(t)をカプラン・マイヤー法による累積生存率曲線で近似すると、その曲線下面積AUCが境界内平均生存時間の近似値になります。 第1節の(注1)と(注2)で説明したカプラン・マイヤー法による生存率の計算法とグリーンウッドの近似式を利用すると、境界内平均生存時間とその分散は次のようになります。
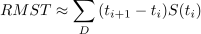 … 死亡例だけ足し合わせる
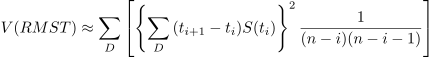

 第12章へ